Ключевые факты
| Параметр | Значение |
|---|---|
| Компания | не раскрывается |
| Категория | Образование и наука |
| Дата | 2026-10-22 |
| Цифры | 15 %; 15 % |
| Статус | в работе |
Что известно
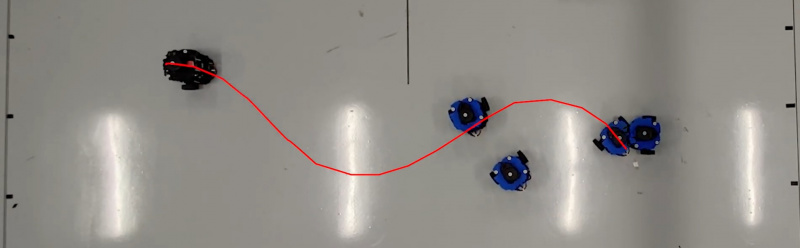
Роботу недостаточно научиться выполнять задачу оптимально: поведение должно оставаться в разумных рамках. До сих пор робототехники получали либо одно, либо другое. Исследователи аэрокосмической инженерии из Колледжа инженерии Грейнджера Иллинойсского университета в Урбане-Шампейне объединили обучение с подкреплением и теорию управления, чтобы гарантировать устойчивость робота и улучшить точность отслеживания до 15% по сравнению с существующими методами.
Статью «Contraction-Aware Reinforcement Learning for Nonlinear Control with Statistical Robustness» написали Минджэ Чо, Хироясу Цукамото и Хью Тран. «Обучение с подкреплением даёт многообещающий способ научить робота эффективному поведению, но ему часто не хватает гарантий устойчивости», говорит аспирант Минджэ Чо, научные руководители которого Хью Тран и Хиро Цукамото.
Что это значит для заказчика
Заявленные 15% прироста точности отслеживания получены в сравнении с существующими методами обучения, а не с вашим контуром управления. Перед внедрением имеет смысл воспроизвести результат на своей платформе и проверить, какие требования метод предъявляет к модели динамики и датчикам.
По теме: сервисные роботы, Робот промоутер Reeman AODS.