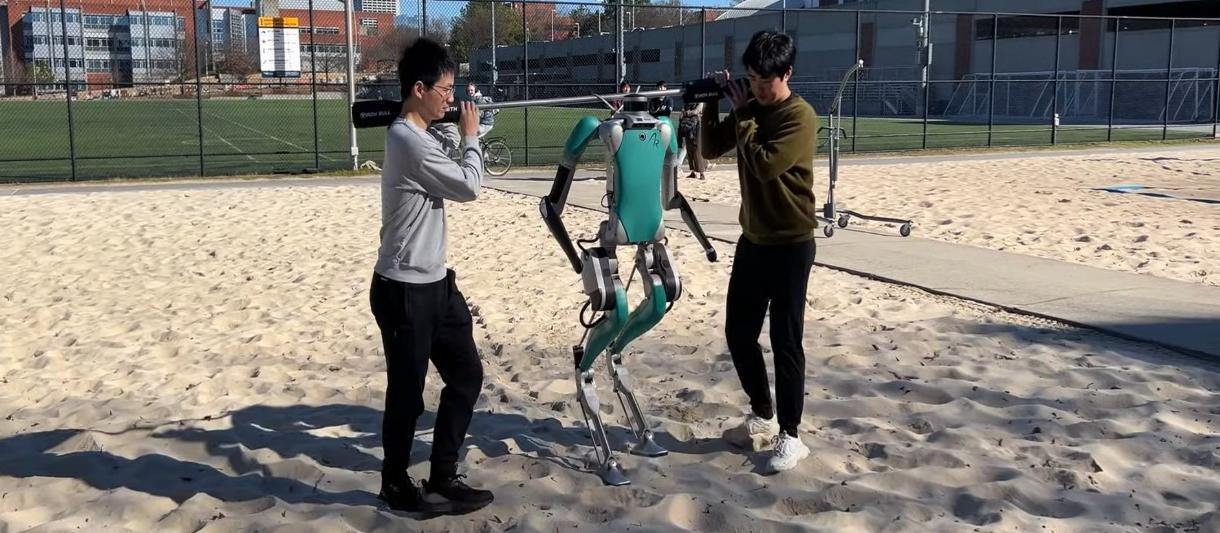
Исследователи из Технологического института Джорджии испытали контроллер машинного обучения, который позволил полноразмерному человекоподобному роботу ходить по песку, гравию, мокрой траве, склонам, лестницам и скользким поверхностям в помещении. Секрет — в ускоренном рецепте обучения с подкреплением, пишет Interesting Engineering.
Работу представили на IEEE International Conference on Robotics and Automation. В её основе лежит фреймворк под названием Learn to Teach.
Как работает Learn to Teach
Обычно сначала тренируют модель-учителя, а потом с её помощью — модель-ученика. Проект Georgia Tech делает и то, и другое одновременно.
В классической схеме обучения с подкреплением, которую описывают авторы, учитель получает доступ к детальным данным симуляции. Он тренируется первым, а затем передаёт свою политику ученику, который управляет реальным роботом.
Ведущий исследователь Фэйян Ву (Feiyang Wu) говорит, что такая последовательность занимает слишком много времени, а полезные данные учителя остаются недоиспользованными.
«Не нужно ждать, пока учитель станет экспертом, чтобы он начал учить ученика», — Фэйян Ву, ведущий исследователь.
В Learn to Teach учитель начинает передавать знания по мере собственного обучения. Команда также позволила учителю учиться на опыте ученика. Это сделано, чтобы сократить разрыв в подражании — он возникает, когда ученик сталкивается с условиями, выходящими за рамки идеализированной симуляции учителя.
Вопросы эффективности
Источник не приводит время обучения, количество GPU или количественную оценку снижения затрат. Так что заявление о вычислительной эффективности остаётся скорее направлением, чем подтверждённым показателем.
Но суть ясна: исследователи пытаются сократить последовательные накладные расходы при переносе навыков ходьбы из симуляции в реальность, сохраняя при этом устойчивость на незнакомой местности.
Испытания на реальном роботе
Контроллер испытали в лаборатории доцента Е Чжао (Ye Zhao) на полноразмерном человекоподобном роботе. Статья не называет модель или производителя, но говорит, что платформа громоздкая и очень высокая.
Во время тестов один и тот же контроллер справлялся с неровным рельефом на улице и скользкими полами в помещении — без отдельных настроек для каждой среды. Команда также толкала и тянула робота, и он менял походку, чтобы сохранить равновесие.
Чжао заявил, что контроллер превзошёл программное обеспечение, которое поставлял производитель робота. Сравнение полезное — если его воспроизвести в контролируемых условиях. Правда, источник не описывает ни заводской контроллер, ни протокол испытаний, ни метрики, по которым проводилось сравнение.
Перспективы метода
Исследователи считают, что Learn to Teach можно адаптировать не только для ходьбы гуманоидов, но и для других роботов и задач, где требуется надёжное движение в непредсказуемой среде.
Смотрите также в каталоге ROBOWIN
Под заказ 25–55 дней, со склада по России 1–3 дня. Частному лицу карта и чек, компании счёт.